文書構造、表、画像情報とともにテキストを抽出するVision OCRモデルです。 抽出した結果をCIPで分析や自動化に活用できます。
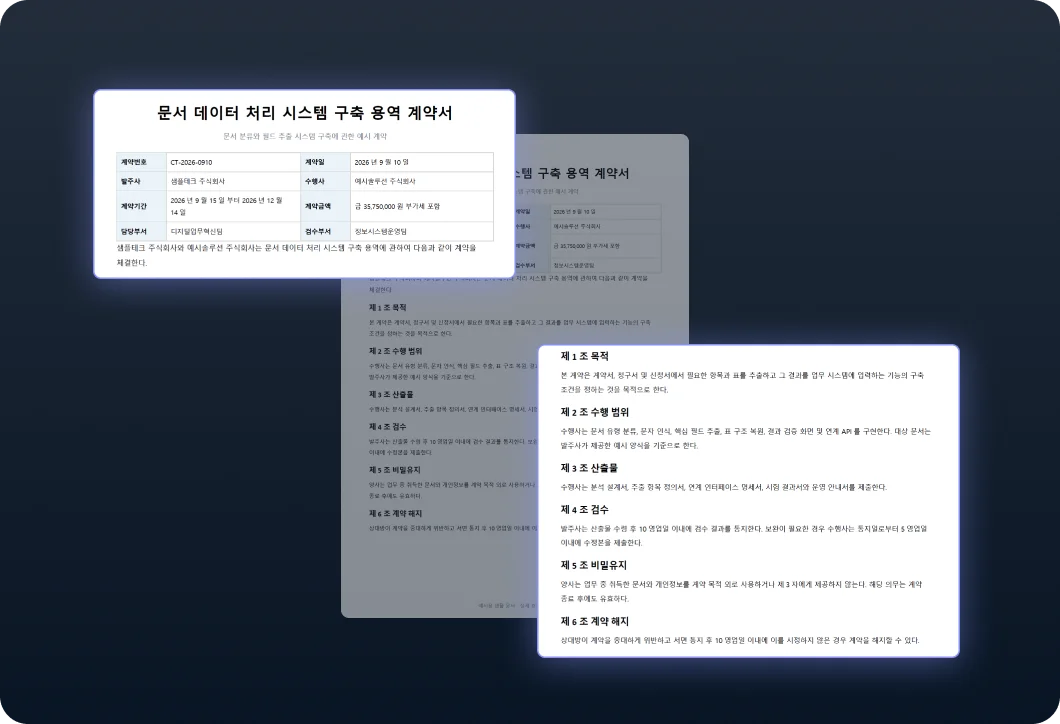
文字を認識するだけでなく、Covaは文書の構造や位置情報を抽出します。 表や画像の情報をまとめて。 結果をCIPに直接接続して、分析と自動化を行います。
次の分析ステップに必要な情報を抽出しながら、文書のレイアウトを保持します。
契約書、請求書、申請書から必要な項目や表を抽出 手作業によるデータ入力を削減します。
見出し、本文、表、位置情報をHTMLに変換します またはMarkdownで検索・分析。
CIPに必要なソース画像のみを送信します 長い文書でもコンテキストをより効率的に活用できます。
このページでは、モデルの機能と選択方法を説明します。正確なモデルID、入力・出力上限、 対応機能とバージョン変更は、開発者向けドキュメントで管理されています。
機械翻訳された言語は clevi/cip-5.5-im によって翻訳され、その旨が表示されます。これは、公開済みのサイトバンドルがある言語に適用されます。
136の言語