COVA MODELS

Баримт бичиг болон зургийн мэдээллийг ажил хэрэг болгоно уу.
Cova-тай танилцана уу.

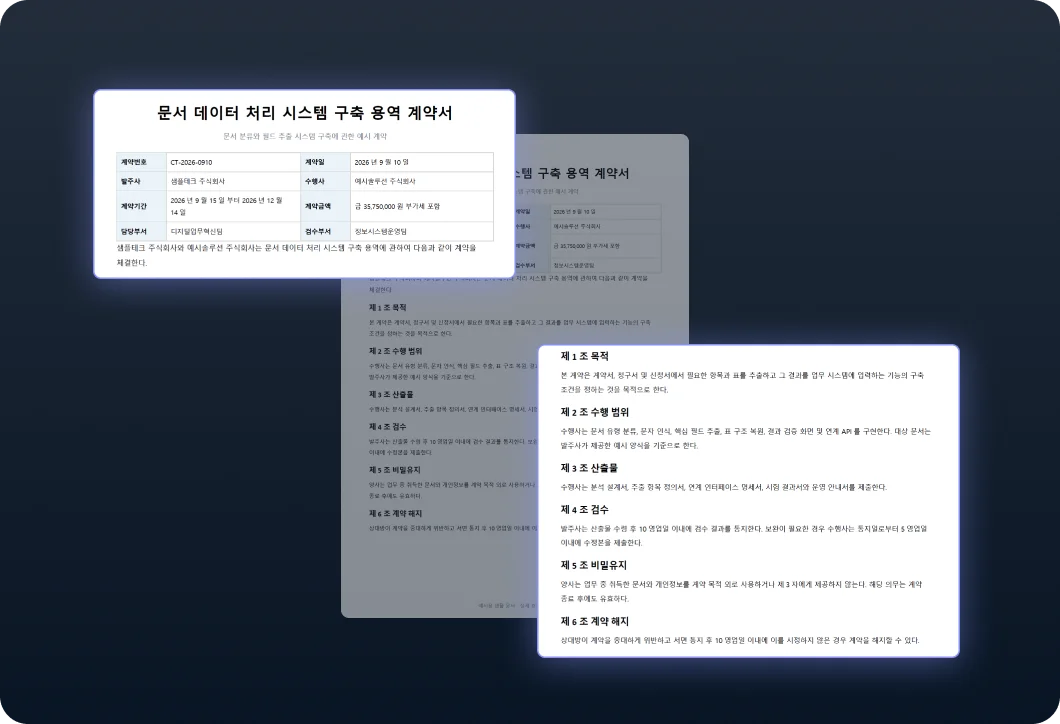
Баримт бичгийн бүтэц, хүснэгт болон зургийн мэдээллийн хамт текстийг гаргаж авдаг Vision OCR загвар.
Задлан авсан үр дүнг CIP ашиглан шинжилгээ болон автоматжуулалтад хэрэглэнэ.

Cova: баримт бичиг уншихад зориулсан тусгай модел

Cova нь тэмдэгт танихаас гадна баримт бичгийн бүтэц, байрлалыг задлан авдаг.
хүснэгтүүд болон зургийн мэдээллийг хамтад нь.
Үр дүнг шууд CIP-тэй холбон шинжилгээ болон автоматжуулалт хийнэ.

  • Гэрээ, тайлан болон нэхэмжлэхийг бүтэцжүүлнэ
  • Хүснэгт болон байрлалыг хадгалан мэдээлэл задлан авна
  • HTML эсвэл Markdown-ыг дараагийн шатны моделуудад дамжуулна

Cova

Дэмжигддэг боломжууд
Сонгомол эх зургийн хяналт · Контекстийн үр ашиг
Зөвлөмж болгож буй хэрэглээ
Баримт бичиг хайх, өгөгдөл оруулалтыг автоматжуулах, олон баримт бичгийн шинжилгээнд зориулан урьдчилан боловсруулах

Cova юу уншиж, хэрхэн бүтэцжүүлдэг вэ

Дараагийн шинжилгээний алхамд шаардлагатай мэдээллийг задлан авахдаа баримт бичгийн байрлалыг хадгална.

Cova-ийн хамгийн сүүлийн үеийн үзүүлэлтүүдийг хөгжүүлэгчийн баримт бичгээс харна уу

Энэ хуудас нь загварын боломжууд болон сонголтыг тайлбарлана. Загварын яг ID, оролт ба гаралтын хязгаар,
дэмжигддэг боломжууд болон хувилбарын өөрчлөлтүүдийг хөгжүүлэгчийн баримт бичигт тогтмол шинэчилдэг.

Моделийн ID-ууд Оролт ба гаралтын үзүүлэлтүүд API-ийн жишээнүүд Өөрчлөлтийн бүртгэл
Cova хөгжүүлэгчийн баримт бичиг

Cova ашиглан баримт бичгийн ажлын урсгалаа автоматжуулна уу

CLEVI

Хэл, бүс нутаг

Машинаар орчуулсан хэлнүүдийг clevi/cip-5.5-im орчуулж, ингэж тэмдэглэнэ. Энэ нь нийтлэгдсэн сайтын багцтай хэлнүүдэд хамаарна.

136 хэл

Санал болгосон

1

Зүүн Ази

7

Зүүн өмнөд Ази

11

Өмнөд Ази

18

Төв Ази

5

Ойрхи Дорнод ба Кавказ

10

Баруун Европ, Өмнөд Европ

16

Их Британи, Ирланд

4

Хойд Европ

10

Төв Европ ба Балкан

14

Зүүн Европ

5

Зүүн Африк

8

Баруун Африк, Төв Африк

9

Өмнөд Африк тив

8

Америк

5

Номхон далайн орнууд

5