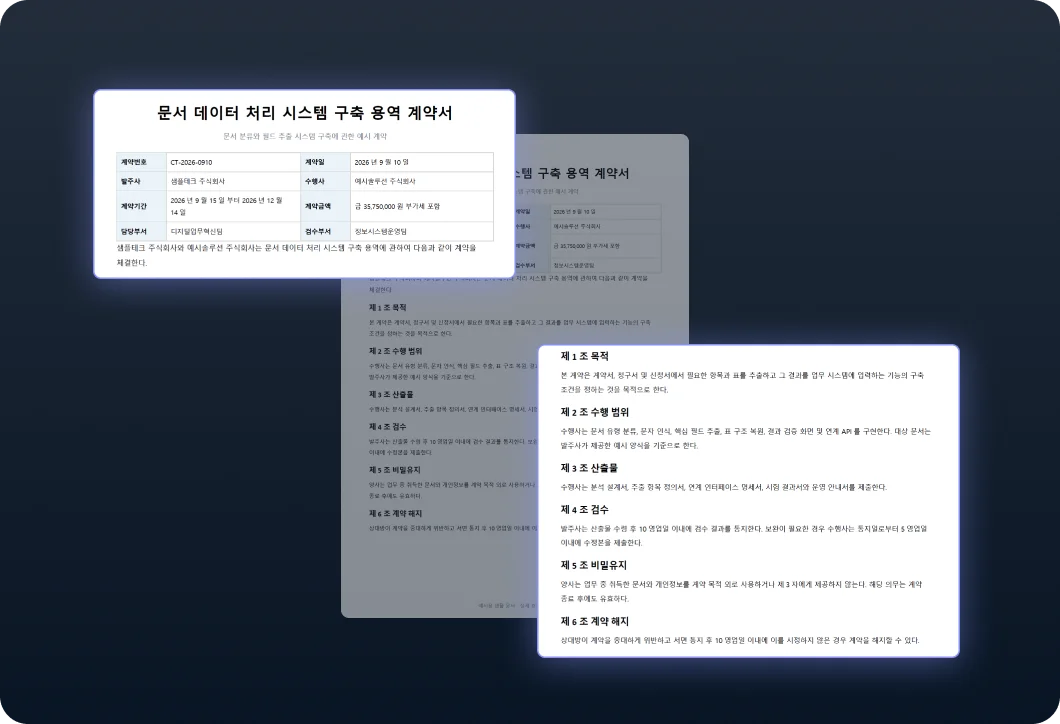
一种可在提取文本的同时提取文档结构、表格和图像信息的视觉 OCR 模型。 使用提取的结果,通过 CIP 进行分析和自动化。
除了识别字符之外,Cova 还可提取文档结构和位置信息、 表格和图像信息。 将结果直接连接到 CIP,用于分析和自动化。
在提取下一分析步骤所需信息的同时保留文档布局。
从合同、发票和申请表中提取所需的字段和表格 减少手动数据录入。
将标题、正文、表格和位置信息转换为 HTML 或 Markdown,用于搜索和分析。
仅发送 CIP 所需的源图像 并更高效地利用长文档的上下文。
本页面介绍模型功能和选择。确切的模型 ID、输入和输出限制、 支持的功能和版本变更均在开发者文档中维护。
机器翻译的语言由 clevi/cip-5.5-im 翻译,并会标注为机器翻译。这适用于已发布网站内容包的语言。
136 种语言