COVA MODELS

حوّل معلومات المستندات والصور إلى قيمة عملية.
تعرّف على Cova.

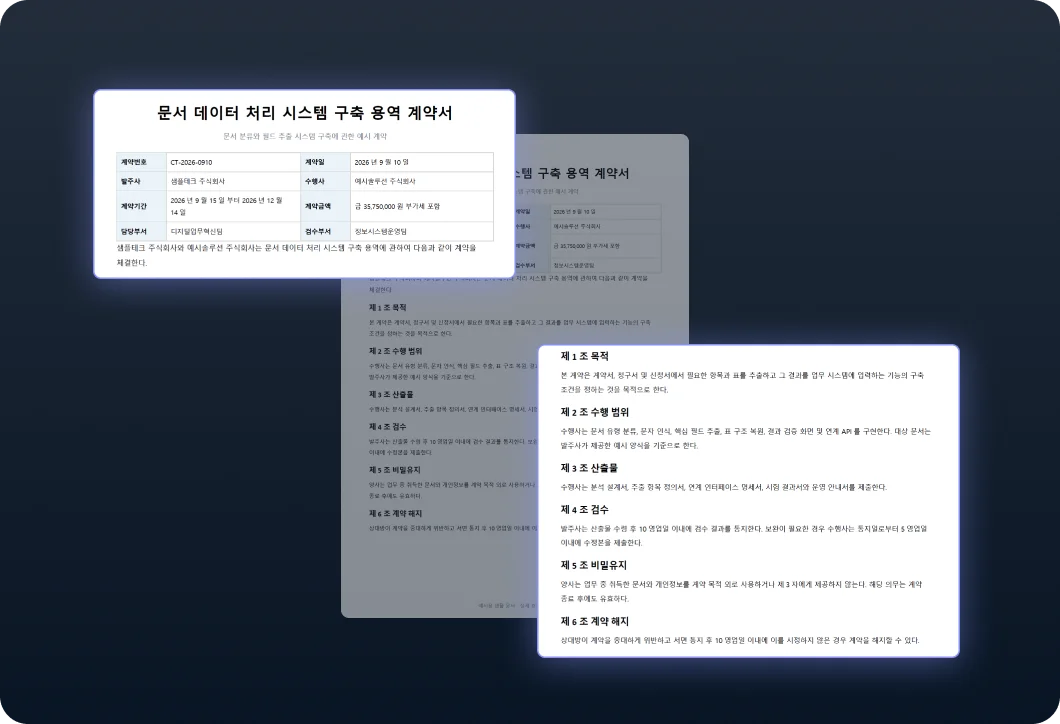
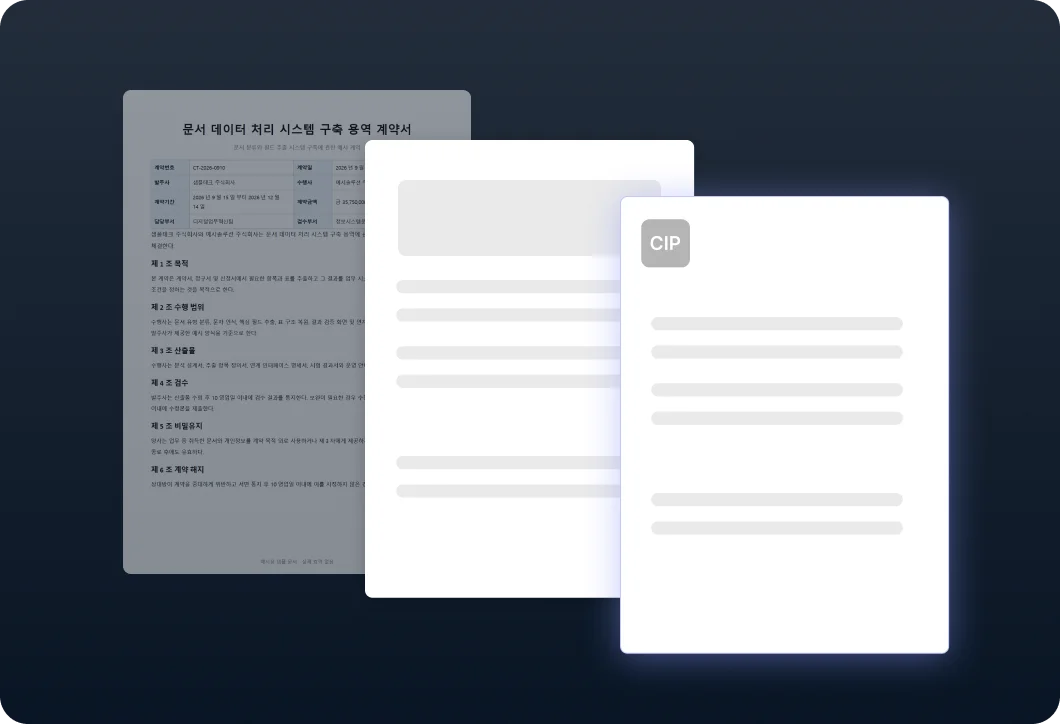
نموذج Vision OCR يستخرج النص إلى جانب بنية المستندات والجداول ومعلومات الصور.
استخدم النتائج المستخرجة للتحليل والأتمتة باستخدام CIP.

Cova: نموذج مخصص لقراءة المستندات

إلى جانب التعرّف على الأحرف، يستخرج Cova بنية المستند ومواضعه،
الجداول ومعلومات الصور معًا.
اربط النتائج مباشرةً بـ CIP للتحليل والأتمتة.

  • هيكلة العقود والتقارير والفواتير
  • استخرج المعلومات مع الحفاظ على الجداول والتخطيط
  • مرّر HTML أو Markdown إلى النماذج اللاحقة

Cova

الميزات المدعومة
مراجعة انتقائية للصور المصدر · كفاءة السياق
الاستخدامات الموصى بها
البحث في المستندات، وإدخال البيانات تلقائيًا، والمعالجة المسبقة لتحليل مستندات متعددة

ما الذي يقرأه Cova ويهيكله

حافظ على تخطيط المستند أثناء استخراج المعلومات اللازمة لخطوة التحليل التالية.

اعثر على أحدث مواصفات Cova في مستندات المطورين

تشرح هذه الصفحة إمكانات النماذج واختيارها. معرّفات النماذج الدقيقة، وحدود الإدخال والإخراج،
يتم توثيق الميزات المدعومة وتغييرات الإصدارات في مستندات المطورين.

معرّفات النماذج مواصفات الإدخال والإخراج أمثلة على API سجل التغييرات
مستندات مطوري Cova

أتمتة سير عمل مستنداتك باستخدام Cova

CLEVI

اللغة والمنطقة

تُترجم اللغات المترجمة آليًا بواسطة clevi/cip-5.5-im ويُشار إليها على هذا النحو. ينطبق ذلك على اللغات التي تتوفر لها حزمة موقع منشورة.

136 لغة

موصى به

1

شرق آسيا

7

جنوب شرق آسيا

11

جنوب آسيا

18

وسط آسيا

5

الشرق الأوسط والقوقاز

10

غرب أوروبا وجنوب أوروبا

16

المملكة المتحدة وأيرلندا

4

شمال أوروبا

10

أوروبا الوسطى والبلقان

14

شرق أوروبا

5

شرق أفريقيا

8

غرب أفريقيا ووسط أفريقيا

9

أفريقيا الجنوبية

8

الأمريكتان

5

أوقيانوسيا

5