โมเดล COVA

นำข้อมูลเอกสารและรูปภาพไปใช้งาน
พบกับ Cova

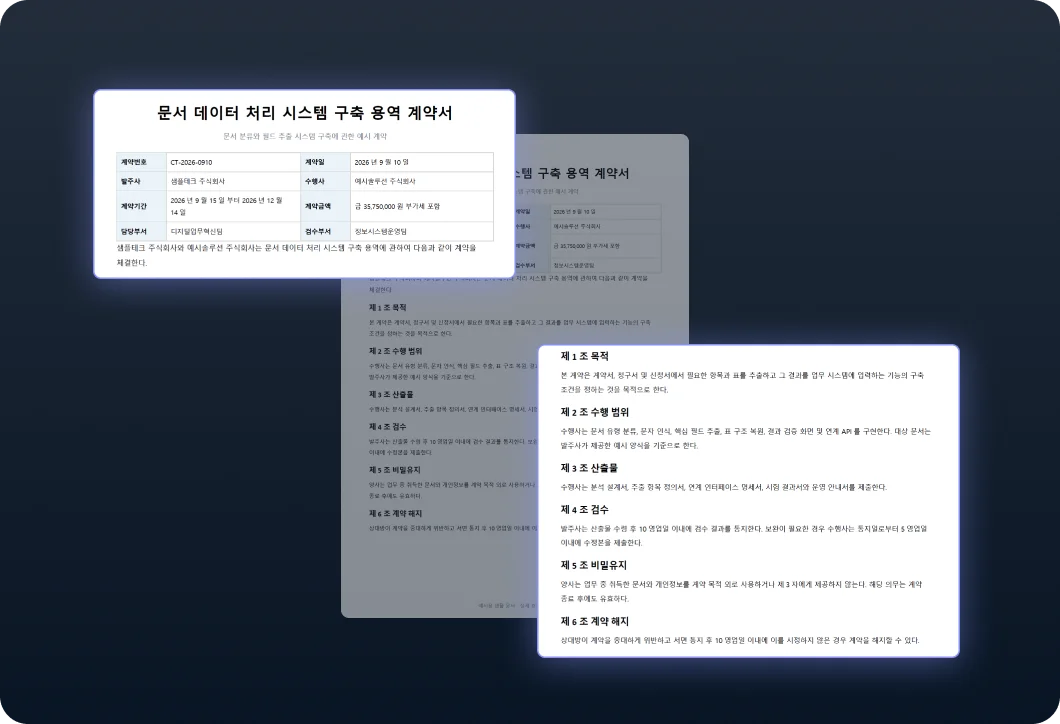
โมเดล Vision OCR ที่แยกข้อความพร้อมโครงสร้างเอกสาร ตาราง และข้อมูลรูปภาพ
ใช้ผลลัพธ์ที่แยกได้สำหรับการวิเคราะห์และการทำงานอัตโนมัติด้วย CIP

Cova: โมเดลเฉพาะสำหรับการอ่านเอกสาร

นอกเหนือจากการรู้จำอักขระแล้ว Cova ยังแยกโครงสร้างเอกสาร ตำแหน่ง
ตารางและข้อมูลภาพไว้ด้วยกัน
เชื่อมต่อผลลัพธ์โดยตรงกับ CIP เพื่อการวิเคราะห์และการทำงานอัตโนมัติ

  • จัดโครงสร้างสัญญา รายงาน และใบแจ้งหนี้
  • แยกข้อมูลโดยคงตารางและเค้าโครงไว้
  • ส่ง HTML หรือ Markdown ไปยังโมเดลปลายทาง

Cova

ฟีเจอร์ที่รองรับ
การตรวจสอบภาพต้นฉบับแบบเลือกเฉพาะรายการ · ประสิทธิภาพของบริบท
การใช้งานที่แนะนำ
การค้นหาเอกสาร การป้อนข้อมูลอัตโนมัติ และการประมวลผลล่วงหน้าสำหรับการวิเคราะห์หลายเอกสาร

สิ่งที่ Cova อ่านและจัดโครงสร้าง

รักษาเค้าโครงเอกสารขณะดึงข้อมูลที่จำเป็นสำหรับขั้นตอนการวิเคราะห์ถัดไป

ดูข้อมูลจำเพาะล่าสุดของ Cova ได้ในเอกสารสำหรับนักพัฒนา

หน้านี้อธิบายความสามารถและการเลือกโมเดล รหัสโมเดลที่แน่นอน ขีดจำกัดอินพุตและเอาต์พุต
ฟีเจอร์ที่รองรับและการเปลี่ยนแปลงเวอร์ชันจะได้รับการดูแลไว้ในเอกสารสำหรับนักพัฒนา

รหัสโมเดล ข้อกำหนดอินพุตและเอาต์พุต ตัวอย่าง API บันทึกการเปลี่ยนแปลง
เอกสารสำหรับนักพัฒนา Cova

ทำให้เวิร์กโฟลว์เอกสารของคุณเป็นอัตโนมัติด้วย Cova

CLEVI

ภาษาและภูมิภาค

ภาษาที่แปลโดยเครื่องแปลจะถูกแปลโดย clevi/cip-5.5-im และมีการระบุว่าเป็นภาษาที่แปลโดยเครื่องแปล ใช้กับภาษาที่มีชุดเว็บไซต์เผยแพร่แล้ว

136 ภาษา

แนะนำ

1

เอเชียตะวันออก

7

เอเชียตะวันออกเฉียงใต้

11

เอเชียใต้

18

เอเชียกลาง

5

ตะวันออกกลางและคอเคซัส

10

ยุโรปตะวันตกและยุโรปใต้

16

สหราชอาณาจักรและไอร์แลนด์

4

ยุโรปเหนือ

10

ยุโรปกลางและบอลข่าน

14

ยุโรปตะวันออก

5

แอฟริกาตะวันออก

8

แอฟริกาตะวันตกและแอฟริกากลาง

9

แอฟริกาตอนใต้

8

อเมริกา

5

โอเชียเนีย

5