一個視覺 OCR 模型,可在擷取文字的同時,提取文件結構、表格及圖像資訊。 使用擷取的結果,透過 CIP 進行分析及自動化。
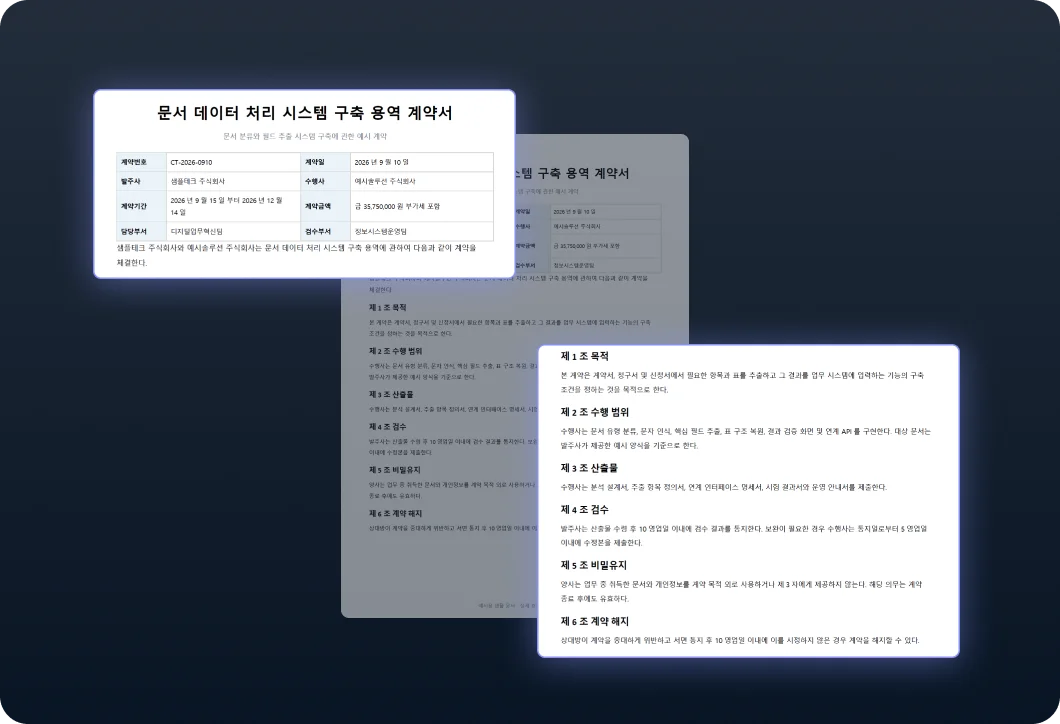
除了識別字元外,Cova 還會擷取文件結構、位置、 表格及圖像資訊。 將結果直接連接至 CIP,以進行分析及自動化。
保留文件版面,同時擷取下一個分析步驟所需的資訊。
從合約、發票及申請表中擷取您所需的欄位及表格 以減少手動資料輸入。
將標題、正文、表格及位置轉換為 HTML 或 Markdown,以進行搜尋及分析。
只傳送 CIP 所需的來源圖像 並更有效地運用長篇文件的內容。
此頁面說明模型功能及選擇方式。具體模型 ID、輸入及輸出限制、 開發者文件會維護支援的功能及版本變更。
機器翻譯的語言由 clevi/cip-5.5-im 翻譯,並標示為此。此適用於具有已發佈網站套件的語言。
136 種語言