Cosa는 텍스트와 음성을 서로 변환하고, 목소리를 등록·재사용하는 음성 AI 제품군입니다. 서비스 안내, 콘텐츠 제작, 접근성 지원, 대화형 에이전트에 활용할 수 있습니다.
음성 합성 · 복제 · 디자인 · 스트리밍과 음성 인식을 조합해 대화 서비스와 음성 인터페이스를 구현합니다.
세부 합성 제어
속도와 언어, 합성 방식까지 세밀하게 제어해야 하는 음성 서비스에 적합합니다.
목소리 선택·맞춤 음성 제작
일관된 브랜드 보이스나 캐릭터 음성을 만들고 재사용할 때 적합합니다.
텍스트 변환·음성 인식
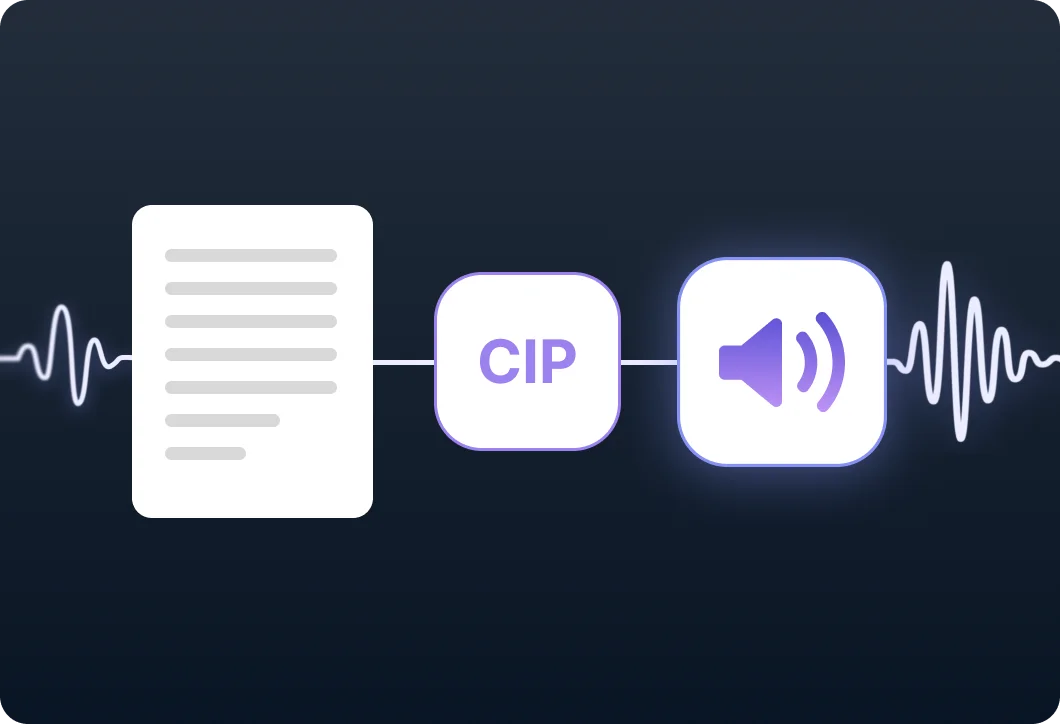
통화 기록, 음성 명령, 상담 내용을 텍스트로 전환해 CIP가 처리하도록 연결합니다.
음성 합성·복제·디자인·인식을 목적에 맞게 선택해 서비스에 적용해보세요.
고객의 말을 Cosa ASR이 텍스트로 옮기고 CIP가 처리한 답변을 Cosa-A 또는 Cosa-B가 음성으로 전달합니다.
설명이나 참조 녹음으로 전용 목소리를 등록하고, 대사와 내레이션을 같은 목소리로 반복 제작합니다.
문장이 완성되는 대로 구절 단위로 합성하고 재생을 제어해 안내와 접근성 서비스를 구성합니다.
홈페이지에서는 모델의 역할과 선택 기준을 설명합니다. 정확한 모델 ID, 입출력 길이, 지원 기능과 버전 변경 사항은 개발자 문서에서 관리합니다.
기계 번역 언어는 clevi/cip-5.5-im으로 번역하여 별도로 표시되며 공개된 사이트 번들이 있는 언어에 적용됩니다.
136개 언어