텍스트뿐 아니라 문서 구조·표·이미지 정보를 함께 추출하는 Vision OCR 모델입니다. 추출한 결과를 CIP의 분석과 자동화에 활용할 수 있습니다.
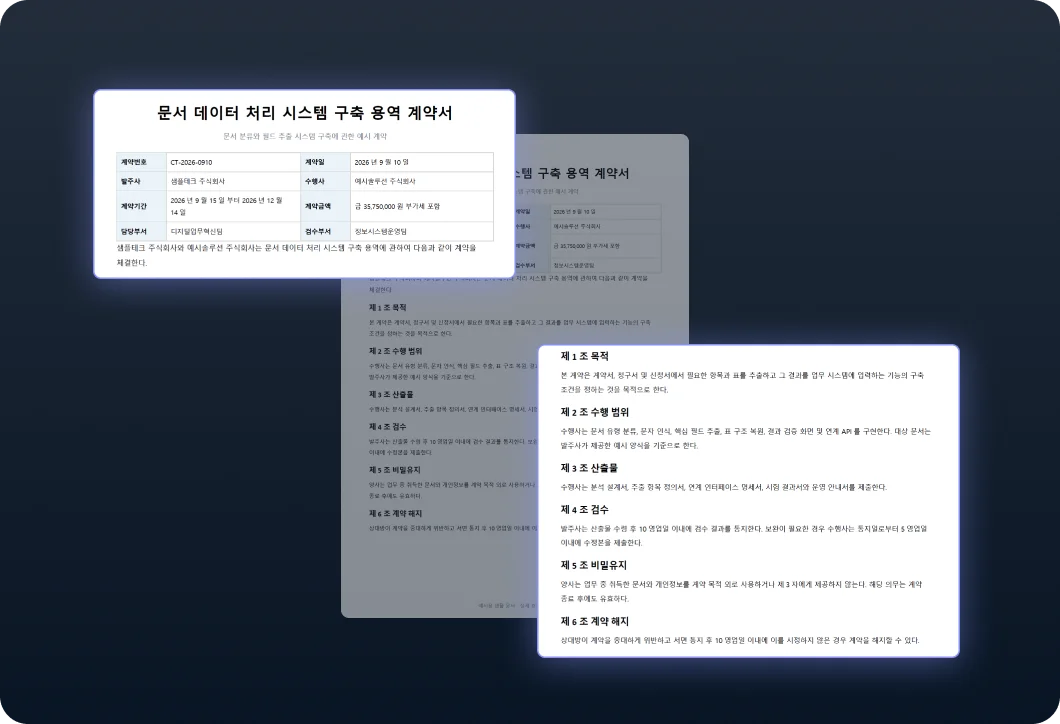
Cova는 글자만 읽는 OCR을 넘어 문서의 구조와 위치, 표와 이미지 정보를 함께 추출합니다. 추출 결과는 CIP의 분석과 자동화에 바로 연결할 수 있습니다.
문서의 형태를 보존하면서 다음 분석 단계에 필요한 정보를 추출합니다.
계약서, 청구서, 신청서에서 필요한 필드와 표를 추출해 시스템 입력 작업을 줄입니다.
제목, 본문, 표, 위치 정보를 HTML이나 Markdown 형태로 만들어 검색과 분석에 활용합니다.
필요한 원본 이미지만 선별해 CIP에 전달하고 긴 문서의 문맥 사용량을 효율화합니다.
홈페이지에서는 모델의 역할과 선택 기준을 설명합니다. 정확한 모델 ID, 입출력 길이, 지원 기능과 버전 변경 사항은 개발자 문서에서 관리합니다.
기계 번역 언어는 clevi/cip-5.5-im으로 번역하여 별도로 표시되며 공개된 사이트 번들이 있는 언어에 적용됩니다.
136개 언어